ブラウザーで画像からテキストを抽出する方法
写真、スクリーンショット、スキャン画像から19言語のテキストをコピーできます。言語を選び、テキストを抽出して、コピーするかTXTファイルとして保存しましょう。
3分で読めます
Tesseract.js OCRエンジンを使用してブラウザで直接画像からテキストを抽出します。英語、ロシア語、中国語、日本語、アラビア語など19言語に対応しています。
光学文字認識(OCR)は、テキストを含む画像を機械が読み取り可能な文字に変換するテクノロジーです。画像内の形状とパターンを分析し、既知の文字表現と照合することで機能します。OCRは印刷されたドキュメントのデジタル化、写真からのテキスト抽出、スキャンされたコンテンツの検索可能性と編集可能性の向上に広く使用されています。
最新のブラウザベースのOCRは、デバイス上で完全に実行される訓練済みニューラルネットワークモデルを使用しています。つまり、画像がサーバーに送信されることはなく、認識はCPUを使用してローカルで行われます。
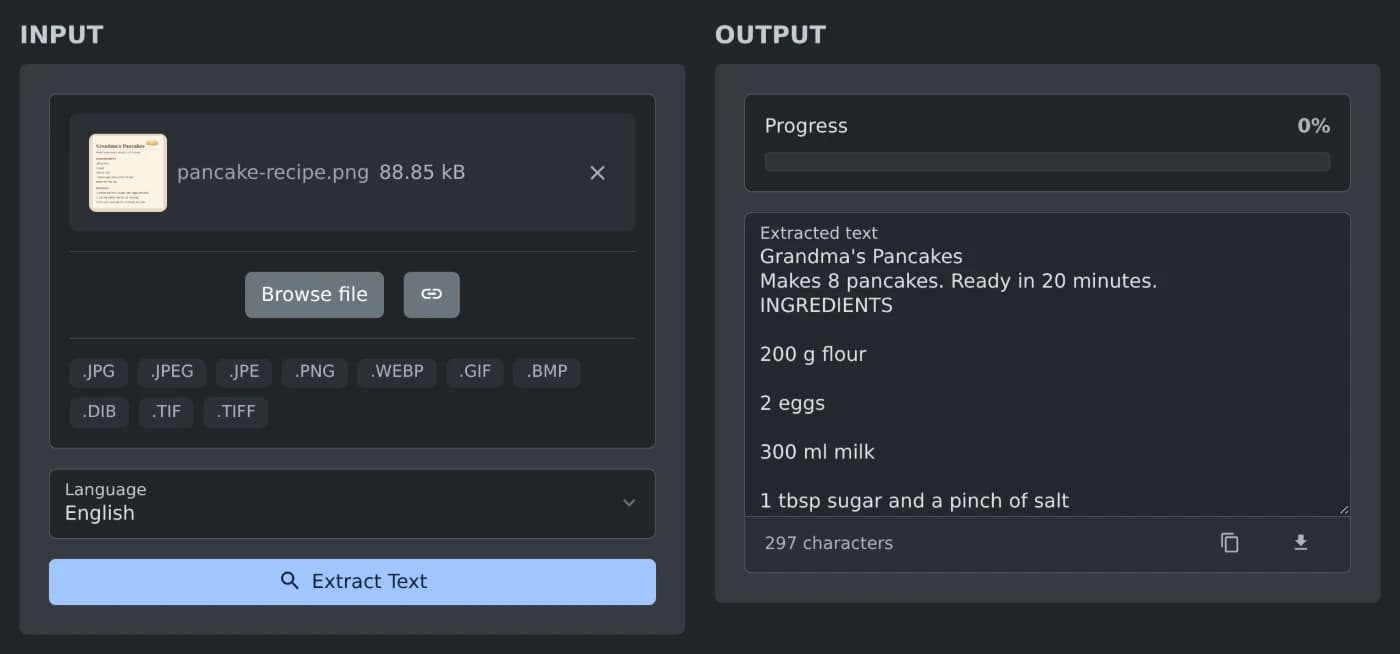
このツールはTesseract.js OCRエンジンを使用して、ブラウザ内で画像から直接テキストを抽出します。写真、スクリーンショット、またはスキャンされたドキュメントをアップロードし、テキストの言語を選択して「テキストを抽出」をクリックします。認識されたテキストは出力エリアに表示され、クリップボードにコピーするか、.txtファイルとしてダウンロードできます。インストール不要、アップロード不要、ページ読み込み後のインターネット接続不要です。
| 形式 | 拡張子 |
|---|---|
| JPEG | .jpg, .jpeg |
| PNG | .png |
| WebP | .webp |
| GIF | .gif |
| BMP | .bmp |
| TIFF | .tif, .tiff |
| 言語 | コード |
|---|---|
| 英語 | eng |
| ロシア語 | rus |
| フランス語 | fra |
| ドイツ語 | deu |
| イタリア語 | ita |
| スペイン語 | spa |
| ポルトガル語 | por |
| オランダ語 | nld |
| ポーランド語 | pol |
| アラビア語 | ara |
| 中国語(簡体字) | chi_sim |
| 中国語(繁体字) | chi_tra |
| 日本語 | jpn |
| 韓国語 | kor |
| ヒンディー語 | hin |
| トルコ語 | tur |
| スウェーデン語 | swe |
| ノルウェー語 | nor |
| フィンランド語 | fin |
写真、スクリーンショット、スキャン画像から19言語のテキストをコピーできます。言語を選び、テキストを抽出して、コピーするかTXTファイルとして保存しましょう。
3分で読めます